Domain web-crawler.de kaufen?
Wir ziehen mit dem Projekt
web-crawler.de um.
Sind Sie am Kauf der Domain
web-crawler.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain web-crawler.de kaufen?
Wie kann man Beautiful Soup oder SeleniumScrapy zum Web Scraping verwenden?
Beautiful Soup und SeleniumScrapy sind Python-Bibliotheken, die zum Web Scraping verwendet werden können. Mit Beautiful Soup kann man HTML- oder XML-Dokumente analysieren und daraus Daten extrahieren. SeleniumScrapy hingegen ermöglicht das automatisierte Durchsuchen von Webseiten, das Klicken auf Links und das Ausfüllen von Formularen. Beide Bibliotheken bieten eine Vielzahl von Funktionen und Methoden, um das Web Scraping effizient und einfach durchzuführen. **
Wie kann ich Beautiful Soup verwenden, um YouTube-Daten abzurufen?
Um YouTube-Daten mit Beautiful Soup abzurufen, musst du zuerst die HTML-Seite der YouTube-Website herunterladen. Dann kannst du Beautiful Soup verwenden, um die gewünschten Daten aus dem HTML-Code zu extrahieren. Du kannst zum Beispiel den Titel, die Beschreibung oder die Anzahl der Aufrufe eines Videos abrufen. **

Ähnliche Suchbegriffe für Beautiful Soup
Top-Angebote
Produkte zum Begriff Beautiful Soup:
-
Beautiful MachinesBeautiful Machines , Beautiful Machines nimmt seine Leser mit auf eine Spritztour durch die Zeit und erzählt die faszinierenden Geschichten der legendärsten Sportwagen. Vom schnittigen Maserati Ghibli über den eleganten Lamborghini Miura und Iso Grifo bis hin zum wegweisenden Design des Alfa Romeo Tipo 33 und zur hochentwickelten Technologie des Porsche 918 Spyder - Beautiful Machines versammelt die Entstehungsgeschichten von über 45 ikonischen Sportwagen und gibt fundierte und spannende Einblicke in ihre raffinierte Technik. Neben einem Überblick über die Geschichte des Automobils von den 1930ern bis heute zeigt das Buch anhand umfangreichen Bildmaterials, wie sich technische Innovation, Design und Zeitgeist gegenseitig beeinflussen. , Sonstige > Transportsysteme , Auflage: 5. Auflage, Erscheinungsjahr: 20191008, Produktform: Leinen, Redaktion: Klanten, Robert, Auflage: 19005, Auflage/Ausgabe: 5. Auflage, Seitenzahl/Blattzahl: 336, Themenüberschrift: SPORTS & RECREATION / Motor Sports / General, Keyword: Sports Cars; Classic Cars; Inconic; Porsche; Collector's cars; Racing; America; Engineering; Race History; Design; Muscle Cars; Formula 1; Race Cars; Formel 1; Autorennen; Rennwagen; Sport, Fachschema: Ingenieurwissenschaft - Ingenieurwissenschaftler~Auto / Bildband, Katalog, Test~Autorennen, Fachkategorie: Ingenieurswesen, Maschinenbau allgemein~Autos: Ratgeber, Sachbuch~Autorennen~Antiquitäten und Sammelobjekte, Thema: Verstehen, Warengruppe: HC/Auto-/Motorrad-/Rad-/Flugsport, Fachkategorie: Motorrennen und Rennsport, Thema: Entdecken, Text Sprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Gestalten, Verlag: Gestalten, Verlag: Die Gestalten Verlag, Länge: 309, Breite: 277, Höhe: 36, Gewicht: 2451, Produktform: Gebunden, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Ähnliches Produkt: 9783899555677 9783899556872 9783899556513 9780008144128 9783899552799, Herkunftsland: DEUTSCHLAND (DE), Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0000, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 178525460,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was ist die Bedeutung des "AttributeError" in Beautiful Soup in Python?
Der "AttributeError" tritt in Beautiful Soup auf, wenn versucht wird, auf ein Attribut oder eine Methode zuzugreifen, die nicht existiert. Dies kann passieren, wenn beispielsweise ein falscher Name für ein Attribut verwendet wird oder wenn das Element, auf das zugegriffen werden soll, nicht die erwarteten Attribute hat. Es ist wichtig, sicherzustellen, dass die richtigen Namen und Attribute verwendet werden, um diesen Fehler zu vermeiden. **
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **

Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
Top-Angebote
Produkte zum Begriff Beautiful Soup:
-
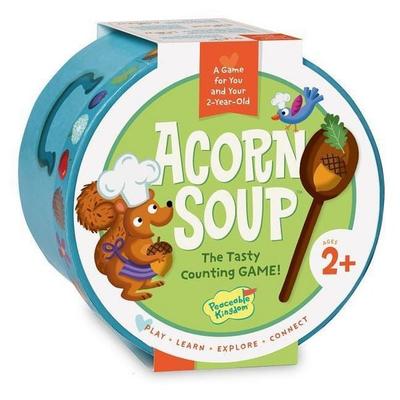
Acorn SoupMaking Acorn Soup Is As Easy As 1-2-3! The Round Box Bottom Doubles A Sa Bowl, Which Contains Wooden Ingredients And A Sturdy Wooden Sppon For Mixing And Stirring. Simple Recipe Cards Teach Toddler To Identify The Ingredients And Count As They Cook....24,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Beautiful MachinesBeautiful Machines , Beautiful Machines nimmt seine Leser mit auf eine Spritztour durch die Zeit und erzählt die faszinierenden Geschichten der legendärsten Sportwagen. Vom schnittigen Maserati Ghibli über den eleganten Lamborghini Miura und Iso Grifo bis hin zum wegweisenden Design des Alfa Romeo Tipo 33 und zur hochentwickelten Technologie des Porsche 918 Spyder - Beautiful Machines versammelt die Entstehungsgeschichten von über 45 ikonischen Sportwagen und gibt fundierte und spannende Einblicke in ihre raffinierte Technik. Neben einem Überblick über die Geschichte des Automobils von den 1930ern bis heute zeigt das Buch anhand umfangreichen Bildmaterials, wie sich technische Innovation, Design und Zeitgeist gegenseitig beeinflussen. , Sonstige > Transportsysteme , Auflage: 5. Auflage, Erscheinungsjahr: 20191008, Produktform: Leinen, Redaktion: Klanten, Robert, Auflage: 19005, Auflage/Ausgabe: 5. Auflage, Seitenzahl/Blattzahl: 336, Themenüberschrift: SPORTS & RECREATION / Motor Sports / General, Keyword: Sports Cars; Classic Cars; Inconic; Porsche; Collector's cars; Racing; America; Engineering; Race History; Design; Muscle Cars; Formula 1; Race Cars; Formel 1; Autorennen; Rennwagen; Sport, Fachschema: Ingenieurwissenschaft - Ingenieurwissenschaftler~Auto / Bildband, Katalog, Test~Autorennen, Fachkategorie: Ingenieurswesen, Maschinenbau allgemein~Autos: Ratgeber, Sachbuch~Autorennen~Antiquitäten und Sammelobjekte, Thema: Verstehen, Warengruppe: HC/Auto-/Motorrad-/Rad-/Flugsport, Fachkategorie: Motorrennen und Rennsport, Thema: Entdecken, Text Sprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Gestalten, Verlag: Gestalten, Verlag: Die Gestalten Verlag, Länge: 309, Breite: 277, Höhe: 36, Gewicht: 2451, Produktform: Gebunden, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Ähnliches Produkt: 9783899555677 9783899556872 9783899556513 9780008144128 9783899552799, Herkunftsland: DEUTSCHLAND (DE), Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0000, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 178525460,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann man Beautiful Soup oder SeleniumScrapy zum Web Scraping verwenden?
Beautiful Soup und SeleniumScrapy sind Python-Bibliotheken, die zum Web Scraping verwendet werden können. Mit Beautiful Soup kann man HTML- oder XML-Dokumente analysieren und daraus Daten extrahieren. SeleniumScrapy hingegen ermöglicht das automatisierte Durchsuchen von Webseiten, das Klicken auf Links und das Ausfüllen von Formularen. Beide Bibliotheken bieten eine Vielzahl von Funktionen und Methoden, um das Web Scraping effizient und einfach durchzuführen. **
-
Wie kann ich Beautiful Soup verwenden, um YouTube-Daten abzurufen?
Um YouTube-Daten mit Beautiful Soup abzurufen, musst du zuerst die HTML-Seite der YouTube-Website herunterladen. Dann kannst du Beautiful Soup verwenden, um die gewünschten Daten aus dem HTML-Code zu extrahieren. Du kannst zum Beispiel den Titel, die Beschreibung oder die Anzahl der Aufrufe eines Videos abrufen. **
-
Was ist die Bedeutung des "AttributeError" in Beautiful Soup in Python?
Der "AttributeError" tritt in Beautiful Soup auf, wenn versucht wird, auf ein Attribut oder eine Methode zuzugreifen, die nicht existiert. Dies kann passieren, wenn beispielsweise ein falscher Name für ein Attribut verwendet wird oder wenn das Element, auf das zugegriffen werden soll, nicht die erwarteten Attribute hat. Es ist wichtig, sicherzustellen, dass die richtigen Namen und Attribute verwendet werden, um diesen Fehler zu vermeiden. **
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
Ähnliche Suchbegriffe für Beautiful Soup
-
Matagot Monster Soup 285946Monster sind immer hungrig und gehen nie weit von einer Tasche voller Vorräte weg, um sich in wenigen Augenblicken eine leckere Suppe zubereiten zu können. ... 1 x Monster Soup Sprache: englische Version Anleitung in: (teilweise nur als Dow19,99 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.